Résumé de l’articleVous manquez de temps aujourd’hui ? Voici l’essentiel en quelques lignes. Vous pourrez revenir à l’article complet plus tard. Lire le résuméMasquer le résumé
Les textes produits par une IA seraient marqués, et ce marquage serait un caractère invisible glissé entre les mots. C’est ce qu’on lit partout depuis quelques semaines. C’est vrai à moitié… et la moitié fausse est justement celle qui voyage le mieux.
L’essentiel
Le marquage existe bel et bien. Anthropic marque les textes de ses modèles concernés partout dans le monde, sans possibilité de refus, depuis le 2 août 2026, et l’a documenté le 14 août. Seuls les modèles lancés à partir de cette date le sont d’office. L’éditeur ne publie ni la liste des modèles actuellement marqués, ni le moyen de savoir si celui qu’on utilise en fait partie, si bien qu’à la question de savoir si votre texte porte une marque, la seule réponse honnête est qu’on n’en sait rien (ni vous, ni moi, ni la personne qui vous vend un nettoyage).
Le caractère invisible, lui, n’existe pas dans ce marquage. La documentation de l’éditeur écrit noir sur blanc que rien n’est ajouté au texte et qu’aucun caractère n’y est caché. Le plus parlant vient d’ailleurs d’un vendeur de détection, Originality.AI indiquant elle-même que sa détection fonctionne aussi bien que les caractères invisibles soient retirés ou non.
Alors où se cache la marque ? Elle est statistique. Elle ne se pose pas sur les mots, elle se loge dans la façon de les choisir, en remplaçant par une clé secrète le hasard qui départage deux mots également valables. D’où sa limite principale, là où le modèle n’a pas le choix des mots, aucune marque ne peut se former. Une relecture d’orthographe ne laisse donc presque rien, une reformulation complète dépose la marque à proportion, et une traduction produite par la machine la marque à neuf.
Deux opérations très différentes se cachent ensuite derrière le mot nettoyage.
- Retirer les caractères invisibles et redresser les guillemets tient dans une table d’une quinzaine de lignes, que n’importe quel éditeur de texte gratuit applique.
- Le filigrane statistique n’habite pas les caractères. Les outils sérieux se contentent de faire réécrire tout le texte par un autre modèle, ce qui aplatit le ton, la voix et la précision, de l’aveu même de leur auteur.
Le verrou qui rend cette économie invérifiable tient en une phrase. Aucun outil public ne sait lire le filigrane d’Anthropic aujourd’hui. Les scores rassurants affichés par certains sites sont mesurés contre des détecteurs d’IA ordinaires, jamais contre cette marque. On vous vend la réussite à un examen que vous ne passiez pas.
Ce que la lecture complète de l’article apporte en plus
Le panorama des éditeurs, qui marque et qui a préféré s’abstenir, avec ce que le Wall Street Journal rapporte du filigrane qu’OpenAI garde au tiroir. Ce que la recherche a réellement démontré sur l’effacement d’une marque, et pourquoi rien de tout cela ne parle de Claude. Le rôle de la longueur du texte, cette variable que personne ne cite. Les risques concrets d’installer ces outils de nettoyage. Et les trois chiffres très recopiés dont je dis franchement n’avoir pas pu lire la source.
Le tout s’appuie sur des sources solides, dont la liste complète se trouve en fin d’article, tout autant que la mini FAQ.
Depuis quelques semaines, la même capture d’écran tourne de fil en fil. Les textes produits par une intelligence artificielle seraient désormais marqués, et ce marquage serait un caractère invisible glissé entre les mots. Certains ajoutent que Google va s’en servir pour vous faire tomber dans le classement. D’autres, plus pratiques, vendent l’outil qui l’enlève.
C’est vrai à moitié, et la moitié fausse est justement celle qui voyage le mieux. Le marquage existe. Il est officiel, il est actif depuis le 2 août 2026, et Anthropic, l’éditeur de l’assistant Claude, l’a documenté en détail le 14 août. Le caractère invisible dans ce marquage, lui, n’existe pas, et l’éditeur écrit noir sur blanc exactement le contraire.
Pendant ce temps, l’outil de nettoyage le plus visible a dépassé les dix-neuf mille étoiles sur GitHub, et des sites commerciaux facturent le service au mois. Celui qui paie achète donc le retrait d’une chose qui ne se trouve pas à cet endroit.
Alors où se cache vraiment le filigrane des textes IA, qu’est-ce qui peut être nettoyé, qu’est-ce qui ne le peut pas, et que vaut ce qu’on vous vend pour l’effacer ?
Je ne prétends pas détenir la vérité sur un sujet qui bouge toutes les semaines. En revanche, je peux séparer ce qui sort d’un texte officiel, ce qui sort d’une étude scientifique, et ce qui n’est que du recopiage de blog en blog. Chaque affirmation porte son lien, vous pourrez donc aller regarder derrière moi. Et quand je n’ai pas pu vérifier quelque chose, ce sera écrit noir sur blanc, ce qui arrive plus souvent qu’on ne l’imagine… l’un des chiffres les plus recopiés de tout ce dossier n’a pas survécu à ma relecture.
Je construis des sites et j’écris pour le web, alors j’ai préféré ouvrir les sources plutôt que les résumés qui en circulent.
Ce qui a été annoncé, et ce qui ne l’a pas été
Anthropic marque les textes produits par les modèles Claude concernés partout dans le monde, sans possibilité de refus. La page officielle du 14 août l’écrit sans ambiguïté, « le marquage s’appliquera aux sorties des modèles concernés partout où Claude est proposé, dans le monde entier ».
Le périmètre est large. L’interface de discussion, l’accès pour les développeurs, les outils de programmation et de bureautique de la maison, ainsi que les versions servies par les grands hébergeurs de calcul. Il n’existe aucun réglage pour désactiver la chose, et aucune page de l’éditeur n’en mentionne un.
Deux dispositifs cohabitent, qu’il vaut mieux ne pas confondre. Les fichiers produits, des images essentiellement, reçoivent des métadonnées de provenance signées au standard C2PA. Ce sont des informations rangées dans le fichier, à côté de l’image. Dans le texte, aucune métadonnée ni aucun caractère ne vient s’ajouter, et c’est là que commence l’histoire.
Comment savoir si la version de Claude qu’on utilise est marquée ?
Toutes les versions de Claude ne sont pas marquées aujourd’hui. Seuls ceux lancés à partir du 2 août 2026 le sont dès leur sortie. Pour les précédents, l’éditeur écrit « la loi européenne prévoit une période de transition pour les modèles antérieurs à cette date, et le travail est en cours pour les marquer aussi ».
Au 7 septembre 2026, Anthropic nomme Fable 5.1 et Mythos 5.1 parmi les modèles pris en charge, et annonce compléter cette liste à mesure du déploiement. Quand j’ai écrit ces lignes, aucune liste n’était publiée.
La conséquence est inconfortable, et elle mérite d’être dite. À la question « est-ce que mon texte porte une marque », la seule réponse honnête aujourd’hui est qu’on n’en sait rien. Ni vous, ni moi… ni la personne qui vous vend un nettoyage.
Le caractère invisible, mythe ou réalité ?
Les caractères invisibles dont parlent les publications qui circulent existent bel et bien, mais ils n’ont aucun rapport avec le marquage d’Anthropic. Ce sont de vieilles curiosités de l’informatique, antérieures de très loin aux assistants d’écriture.
Un caractère invisible, c’est un signe que votre ordinateur compte comme les autres et que votre œil ne voit pas. L’espace de largeur nulle, par exemple, occupe une place dans le fichier sans occuper la moindre place à l’écran. Un peu comme une case vide dans une grille de mots croisés (elle ne montre rien, et elle compte quand même). Il en existe une petite famille, avec l’espace insécable, l’espace fine et le trait d’union conditionnel.
Des utilisateurs ont effectivement relevé une espace fine insécable dans les sorties de certains modèles d’OpenAI, et ces constats sont reproductibles. Attention toutefois à ce qu’ils prouvent. Ce sont des observations d’utilisateurs sur des forums, pas une politique d’éditeur annoncée, et personne n’a montré qu’il s’agissait d’un marquage volontaire plutôt que d’un effet de bord de la mise en forme.
Le plus parlant vient d’ailleurs, et c’est un vendeur de détection qui le fournit. Originality.AI indique elle-même que sa détection fonctionne aussi bien que les caractères invisibles soient retirés ou non. Autrement dit, l’entreprise qui vit de la détection explique que son produit ne repose pas dessus.
Voilà pour la piste que tout le monde suit… Reste à savoir où la marque se trouve réellement.
Où se cache vraiment le filigrane ?
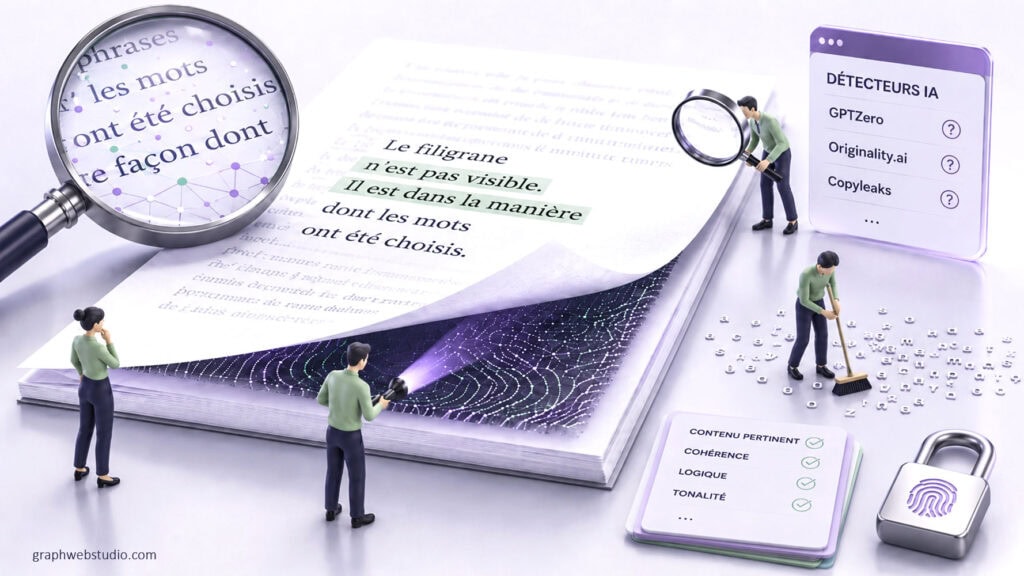
Le filigrane des textes IA est statistique. Il ne se pose pas sur les mots, il se loge dans la façon de les choisir.
Un mot d’abord sur la machine elle-même. Ce qu’on appelle couramment une IA d’écriture est un grand modèle de langage (LLM), un programme qui ne recopie aucune phrase toute faite. Il avance mot après mot, et à chaque pas il évalue lesquels pourraient venir ensuite. Très souvent, plusieurs conviennent aussi bien… et il en tire un au hasard.
C’est ce hasard, et lui seul, que le filigrane vient remplacer. Le modèle consulte une clé secrète, regarde les mots déjà posés, et tranche toujours selon la même règle. La phrase reste naturelle. La suite des choix, elle, forme un motif que seul le détenteur de la clé peut retrouver.
La documentation d’Anthropic le dit en une phrase, et elle mérite d’être lue lentement.
« Rien n’est ajouté au texte, il n’y a aucun caractère caché, et le filigrane modifie seulement la source du hasard qui sert à choisir entre les mots. »
Anthropic, « How Claude’s text watermarking works », 14 août 2026
Une lettre écrite avec une règle convenue
Prenez une lettre manuscrite, tout ce qu’il y a de plus ordinaire. Avant de l’écrire, vous convenez d’une règle avec la personne qui la recevra. Chaque fois que vous pourrez écrire « voiture » ou « auto », deux mots qui disent la même chose, vous trancherez selon cette règle plutôt qu’au petit bonheur.
La lettre part. Elle se lit normalement, elle ne cache rien, il n’y a ni encre sympathique entre les lignes ni message dans les marges. N’importe qui peut la lire par-dessus votre épaule sans rien remarquer, et pour cause, il n’y a rien à remarquer. Seule la personne qui possède la règle peut vérifier, après coup, que la lettre vient bien de vous.
Le filigrane fait exactement cela, à deux différences près. La règle est une clé secrète que vous ne connaîtrez jamais, et les occasions de l’appliquer se comptent par milliers dans un texte un peu long.
Pourquoi une correction d’orthographe ne laisse-t-elle presque rien ?
Cette mécanique a besoin de choix pour exister, et c’est sa limite la plus importante. Là où le modèle n’a pas le choix des mots, aucun filigrane ne peut se former, faute de quoi que ce soit à trancher.
Les chercheurs qui ont posé les fondations de cette technique le reconnaissent eux-mêmes, dans un travail présenté à la conférence ICML en 2023. « Low entropy text creates two problems for watermarking », un texte à faible entropie pose deux problèmes au filigranage. D’une part les humains et les machines produisent alors des suites presque identiques, ce qui rend la distinction impossible. D’autre part le marquage lui-même devient difficile à poser.
L’entropie, ici, désigne simplement la quantité de choix disponibles. Un texte à faible entropie est un texte où tout est contraint d’avance. Il n’existe qu’une seule façon correcte d’écrire « accueil », donc aucune bifurcation, donc aucune signature possible.
La technique elle-même n’est pas maison. Anthropic déclare employer « une version de l’approche SynthID-Text publiée par Google DeepMind », dont les travaux ont paru dans la revue Nature en octobre 2024.
Qu’est-ce qui décide de la force d’un filigrane ?
La force d’un filigrane dépend notamment de la proportion de mots réellement produits par le modèle. Plus il en écrit, plus la marque peut s’installer.
L’éditeur traite explicitement le cas de la relecture, ce qui est assez rare pour être signalé. « Quand Claude relit un texte écrit par une personne, ce qu’il rend n’a généralement été que légèrement modifié, et comme la quasi-totalité des mots appartient à cette personne, le filigrane n’a presque rien à quoi s’accrocher. »
Faire reformuler un paragraphe entier n’est plus du tout la même opération. Là, les mots rendus viennent de la machine, et la marque se dépose à proportion.
Le format compte tout autant. « La détection fonctionne mal sur de petits échantillons, où les choix de mots sont moins nombreux et l’information plus maigre. » Une publication de deux cents mots peut donc passer sous le radar… même entièrement rédigée par la machine.
Et il y a là une ironie que peu de gens ont relevée. « Une traduction produite par Claude porte un filigrane, parce que dans ce cas chaque mot est choisi par Claude. » Faire réécrire par la machine un texte issu de la machine ne l’efface donc pas, ça le marque à neuf.
Une dernière phrase officielle mérite sa place, parce qu’elle est la plus honnête du lot. « Le filigrane ne permet pas de distinguer un texte écrit par Claude d’un texte fortement retravaillé par Claude. » L’éditeur présente donc sa propre marque comme un signal, jamais comme une preuve.
Google marque, OpenAI a préféré ne pas
Anthropic et Google sont aujourd’hui les deux acteurs pour lesquels j’ai trouvé un marquage du texte documenté sur un assistant grand public. Le contraste avec les autres éditeurs raconte l’essentiel de cette affaire.
Google marque depuis 2024 dans Gemini, et a publié son code. La maison reconnaît d’ailleurs ses propres limites, les scores de confiance chutent quand un texte est profondément réécrit ou traduit dans une autre langue. Un bémol utile, venant de celui qui a inventé le procédé.
OpenAI, c’est une autre histoire. L’entreprise a retiré son propre détecteur le 20 juillet 2023, faute de fiabilité, avec des chiffres qu’elle a publiés elle-même. Il ne repérait que 26 % des textes de machine et signalait à tort 9 % des textes humains (soit un texte humain sur onze, accusé sans raison).
Plus intéressant encore, le Wall Street Journal rapportait en août 2024 qu’OpenAI possède depuis des années un filigrane textuel, annoncé en interne à 99,9 % de précision, et qu’elle a choisi de ne pas le déployer. Le motif cité relève du commerce, une enquête interne indiquant qu’environ 30 % des utilisateurs partiraient. Ce point vient de la presse et non d’une annonce officielle, je le donne donc comme tel.
Détail savoureux au passage, les images produites par ChatGPT portent bien une marque. Leur texte, pas encore.
Quant à Meta, ses chercheurs publient sur le sujet depuis 2023 sans que rien ne soit visible en production. Et Mistral, éditeur européen pourtant soumis au même règlement depuis le 2 août, n’annonce aucun dispositif. J’ai cherché sur ses pages légales, il n’y a rien.
| L’éditeur | Marque-t-il le texte ? | Ce qu’on en sait, et d’où ça vient |
|---|---|---|
| Anthropic, Claude | oui, depuis le 2 août 2026 | documenté publiquement le 14 août 2026, sans possibilité de refus |
| Google, Gemini | oui, depuis 2024 | SynthID-Text, code publié, travaux parus dans la revue Nature en octobre 2024 |
| OpenAI, ChatGPT | aucun marquage textuel documenté à ce jour, oui pour les images et l’audio | détecteur retiré le 20 juillet 2023 ; filigrane textuel prêt mais non déployé, d’après le Wall Street Journal d’août 2024 |
| Meta | aucun marquage textuel actif documenté trouvé | publications de recherche depuis 2023, rien de visible en production |
| Mistral | aucun marquage textuel actif documenté trouvé | aucun dispositif annoncé, rien sur ses pages légales |
Ce panorama dit plus qu’un long commentaire. La technologie existe depuis des années chez le plus gros acteur du marché, et ce qui l’a maintenue au tiroir n’est pas une difficulté technique.
Qu’est-ce qui se nettoie, et qu’est-ce qui ne se nettoie pas ?
Deux opérations très différentes se cachent derrière le mot nettoyage, et il vaut la peine de les séparer avant de sortir sa carte bleue.
La première fonctionne parfaitement. Retirer les caractères invisibles, remplacer les tirets longs par des traits d’union, redresser les guillemets courbes, débusquer les homoglyphes. Dans les dépôts les plus visibles, le cœur du réacteur tient dans une table de correspondance d’une quinzaine de lignes. C’est un rechercher-remplacer, celui-là même que fait n’importe quel éditeur de texte gratuit.
Mon interprétation, et je la donne comme une interprétation, c’est qu’une bonne part de ce qui se facture au mois sous le nom de nettoyage relève de cette première couche. Un travail réel… mais que vous faites vous-même en trois clics.
La seconde opération est d’une autre nature. Aucun rechercher-remplacer n’atteindra jamais le filigrane statistique, puisqu’il n’habite pas dans les caractères. Les outils sérieux le savent, et leur couche dite statistique se contente de faire réécrire tout le texte par un autre modèle.
| Le nettoyage des caractères | Le nettoyage du filigrane statistique | |
|---|---|---|
| Ce qu’il atteint | caractères invisibles, tirets longs, guillemets courbes, homoglyphes | rien directement, le filigrane n’habite pas les caractères |
| Comment il s’y prend | une table de correspondance d’une quinzaine de lignes | en faisant réécrire tout le texte par un autre modèle |
| Ce qu’il coûte | rien, n’importe quel éditeur de texte gratuit le fait | le ton, la voix et la précision, de l’aveu de l’auteur de l’outil |
| Ce qu’il prouve | on voit le résultat | rien, aucun outil public ne sait lire ce filigrane |
L’auteur de l’outil le plus étoilé écrit lui-même ce que cela coûte. « Toute réécriture remplace les choix de mots d’origine par ceux du modèle qui réécrit, ce qui aplatit le ton, la voix et la précision. » Il ajoute que sur du texte professionnel, cette dégradation est réelle et souvent visible par ceux qui tiennent le plus à leur écriture.
Le bémol dont personne ne parle
Installer ces outils n’est pas un geste anodin, et le risque y est mieux documenté que l’efficacité. Une installation de paquet, chez les développeurs, peut exécuter du code avant même qu’on lance le programme. L’agence américaine de cybersécurité a publié une alerte en septembre 2025 sur une compromission massive de l’écosystème npm, avec un ver capable de se propager seul et un logiciel malveillant qui fouillait les environnements à la recherche de clés et d’identifiants.
Quant aux extensions de navigateur qui nettoient le presse-papiers, elles ont une particularité assez drôle. Une extension qui nettoie ce que vous copiez doit, pour fonctionner, pouvoir lire ce que vous copiez… mots de passe compris.
Les services en ligne posent la même question autrement. Coller le texte d’un client dans un formulaire inconnu, c’est le confier à un tiers dont vous ignorez tout. Pour quelqu’un qui travaille sous contrat, ce n’est pas une affaire de confort.
Attention
Une extension qui nettoie ce que vous copiez doit, pour fonctionner, pouvoir lire ce que vous copiez… mots de passe compris. Et installer un paquet peut exécuter du code avant même qu’on lance le programme. L’agence américaine de cybersécurité a documenté en septembre 2025 un logiciel malveillant qui fouillait les environnements à la recherche de clés et d’identifiants.
Non, ce n’est pas du pipeau
La recherche a démontré qu’on peut effacer un filigrane statistique, et il serait malhonnête de prétendre l’inverse. C’est même la partie la mieux établie du dossier.
Une équipe menée par Hanlin Zhang a démontré à l’ICML 2024 l’impossibilité du filigrane dit fort, celui qu’un attaquant aux moyens limités ne pourrait pas retirer sans abîmer sérieusement le texte. Le résultat tient même lorsque la clé reste secrète, ce qui prive le camp d’en face de son argument le plus commode.
Plus troublant, un laboratoire de l’École polytechnique fédérale de Zurich a mesuré ses attaques directement sur SynthID-Text, le procédé dont Anthropic s’inspire. Verdict, un effacement réussi dans plus de 90 % des cas avec un paraphraseur prêt à l’emploi, sans même chercher à voler la clé. Leur formule est sobre, « même des adversaires moins puissants peuvent facilement effacer SynthID-Text des textes filigranés ». Ces chiffres viennent du billet du laboratoire, publié en décembre 2024, et non de la version relue par les pairs qui l’accompagne.
Sauf que rien de tout cela ne parle de Claude
Aucun de ces résultats n’a été mesuré sur le système d’Anthropic, et c’est la nuance qui fait toute la différence. Aucun de ces travaux ne porte sur la variante utilisée par Claude, et aucun acheteur de nettoyage ne dispose aujourd’hui de son détecteur.
Un banc d’essai présenté à la conférence EMNLP en 2025 l’a chiffré. Sous une attaque identique, le même filigrane voit son taux de détection passer de 0,858 à 0,334 selon le modèle sur lequel il est posé, sur une échelle où 1 signifie une détection parfaite. Plus du double… et il aura suffi de changer de machine. Rien ne se transpose tel quel d’un modèle à l’autre.
La longueur, cette variable que personne ne cite
Deux études sérieuses semblent se contredire sur la survie d’un filigrane à la paraphrase, et une différence saute aux yeux. Elles ne travaillent pas sur des textes de la même taille.
La première teste des passages d’environ 300 jetons et conclut à l’effondrement de la détection. La seconde, signée des inventeurs mêmes du procédé, teste plus long et conclut à sa survie. « Après une forte paraphrase humaine, le filigrane reste détectable au bout de 800 jetons observés en moyenne, pour un taux de fausse alerte fixé à une sur cent mille. » Huit cents jetons représentent environ 500 mots.
Les deux ont raison. Le mécanisme est donné par les auteurs eux-mêmes, une paraphrase laisse statistiquement fuir des fragments de l’original, et le signal s’accumule là où le bruit ne s’accumule pas. Reste que rien ne prouve que la taille explique tout, les deux équipes ne filigranent pas le même modèle et ne paraphrasent pas de la même façon.
D’où une conclusion réjouissante par son ironie. Un texte court porte le filigrane comme les autres, mais il est trop court pour qu’on arrive à le lire. Un dossier long, lui, échappe à l’effacement fait main parce qu’il est trop long pour qu’on n’y laisse aucune trace… et les deux formats les plus pratiqués sur le web se trouvent chacun à un bout de cette histoire.
Et l’argument du texte abîmé tient mal
On entend souvent qu’une paraphrase automatique détruit le texte, ce qui rendrait l’opération sans intérêt. Les mesures publiées soutiennent mal cet argument.
Une étude parue dans une revue à comité de lecture indique que sa méthode « ne dégrade la qualité du texte que légèrement dans bien des cas ». Le banc d’essai de l’EMNLP va dans le même sens, « la plupart des attaques préservent le sens du texte filigrané ».
Des chiffres plus précis circulent beaucoup, attribués à cette même étude. Une perplexité qui passe de 5,2 à 8,7, et jusqu’à 10,5 selon l’outil de réécriture employé, après cinq tours de paraphrase, un contenu jugé préservé dans 70 à 83 % des passages, une grammaire jugée bonne dans 88 à 89 % des cas. La perplexité mesure à quel point un texte est prévisible, et plus elle est basse, plus la suite des mots va de soi.
Ces trois chiffres n’apparaissent pas dans le résumé de l’étude. Ils sont plus loin, dans le texte intégral, aux tableaux 1 à 3… et ils sont exacts.
Ce qu’ils décrivent, c’est un texte devenu moins prévisible, et dont le sens et la grammaire tiennent encore… Pas un texte cassé. À noter tout de même, le développeur cité plus haut prévient que la dégradation se voit sur du texte professionnel. Les deux constats ne se contredisent pas vraiment. On peut très bien préserver le sens d’une phrase et lui retirer tout ce qui faisait sa voix.
Aucun outil public ne peut vérifier quoi que ce soit
Aucun outil public ne sait lire le filigrane d’Anthropic aujourd’hui, et c’est le verrou qui rend toute cette économie invérifiable. Quatre raisons se cumulent, dont chacune suffirait.
La première, l’éditeur a d’abord annoncé un outil de vérification sans le livrer. Il existe depuis en préversion privée, réservée à des organisations éligibles au titre du droit européen, régulateurs, médias, vérificateurs de faits, chercheurs, organismes éducatifs. Pour tous les autres, il n’y a toujours rien.
La deuxième, le code ouvert publié par Google réclame la clé pour fonctionner. Sa documentation précise qu’il sert la reproductibilité scientifique et n’est pas conçu pour la production. Il vérifie un filigrane que vous avez posé vous-même, avec vos propres clés. Un thermomètre qui ne mesure que la fièvre qu’on lui a donnée.
La troisième, le détecteur de Google ne verrait pas celui de Claude. Anthropic emploie une version du procédé, avec ses clés à elle, et l’outil de Google couvre les productions de Google.
La quatrième est la plus parlante, parce qu’elle vient des intéressés. Un article de BleepingComputer du 13 août 2026 le formule ainsi, « aucune des affirmations sur le contournement du filigrane textuel ne peut être vérifiée à l’heure actuelle ».
L’examen que vous ne passiez pas
Voici le cœur du problème, et il tient dans une phrase du même article. « Les scores que certains de ces sites renvoient sont mesurés contre des détecteurs d’IA ordinaires, et non contre le filigrane d’Anthropic, pour lequel aucun détecteur public n’existe. »
C’est là que le tour de passe-passe apparaît. Le score rassurant qu’on vous montre a été obtenu face à des outils qui ne lisent aucun filigrane et n’en ont jamais lu. Passer sous l’un d’eux ne dit strictement rien de la marque d’Anthropic. On vous vend la réussite à un examen que vous ne passiez pas.
Et l’aveu le plus utile de toute cette histoire vient de l’endroit le plus inattendu. Le développeur de l’outil le plus étoilé écrit, dans sa propre documentation, « Tant que les éditeurs n’auront pas publié de détecteurs et de clés, aucun outil ne peut honnêtement certifier qu’un texte échoue au contrôle officiel. »
Celui qui a écrit le programme dit donc lui-même ce que les sites commerciaux facturent. Un ingénieur logiciel, Pasquale Pillitteri, rapporte d’ailleurs avoir testé plusieurs nettoyeurs populaires en lisant leur code plutôt que leur documentation, et retrouvé intacte, après passage, la charge cachée qu’ils prétendaient avoir retirée. Certains n’ôtent même pas… les caractères qu’ils promettent d’ôter.
La lettre, une dernière fois. Vous l’avez entièrement réécrite de votre main. Porte-t-elle encore les choix convenus ? Sans la règle, ni vous ni personne ne peut le dire… et c’est précisément cette réponse impossible qui se facture au mois.
Ce qui vous reste en main
Le filigrane des textes IA existe, il est officiel, et il ne se trouve nulle part où on le cherche. Il ne vit pas dans un caractère caché mais dans la façon dont les mots ont été choisis, il devient plus détectable à mesure que le texte s’allonge, et aucun outil public ne permet à ce jour de le lire.
Une inquiétude, au moins, peut être rangée. Votre référencement n’est pas en jeu. Google écrit dans sa documentation qu’il ne sanctionne pas l’origine d’un texte mais la production en masse de pages sans valeur, et rien ne documente aujourd’hui un accès de Google au dispositif qui permettrait de lire ce filigrane. Ce qui compte pour lui reste ce qui comptait déjà, et j’en ai parlé ailleurs à propos des moteurs de réponse qui vous citent sans vous trouver.
Le vrai risque est ailleurs, et il n’a rien à voir avec le filigrane. Il tient au faux positif d’un détecteur du commerce, qui ne lit aucune marque et se contente de deviner un style, face à quelqu’un qui dispose de peu de moyens pour prouver son innocence. C’est un sujet à part entière, et il a désormais le sien, sur ce qui se passe quand un détecteur de texte IA vous accuse à tort.
En attendant, le geste utile ne coûte rien et ne s’installe pas. Un rechercher-remplacer dans un éditeur de texte que vous possédez déjà retire les caractères invisibles et les tics de ponctuation, ce qui est très exactement ce que les nettoyeurs savent faire. Le reste, aucun d’eux ne peut le prouver, et ils sont plusieurs à l’écrire eux-mêmes.
La lettre, elle, continue de dire exactement ce qu’elle dit… C’est bien la seule chose dont on soit certain dans toute cette affaire.
Questions fréquentes
Est-ce que tous les textes produits par Claude sont marqués aujourd’hui ?
Non. Seuls les modèles lancés à partir du 2 août 2026 marquent dès leur sortie, les précédents bénéficiant d’une période de transition. Anthropic nomme aujourd’hui Fable 5.1 et Mythos 5.1 parmi les modèles pris en charge.
Y a-t-il des caractères invisibles cachés dans les textes d’IA ?
Pas comme filigrane chez Claude. La documentation d’Anthropic indique que rien n’est ajouté au texte et qu’aucun caractère caché n’y figure. Des espaces atypiques ont bien été relevés par des utilisateurs dans les sorties de certains modèles concurrents, mais aucun éditeur n’a présenté cela comme un dispositif de marquage.
Google peut-il lire le filigrane d’Anthropic pour me déclasser ?
Rien ne permet aujourd’hui de dire que Google le peut. Lire ce filigrane exige la clé secrète d’Anthropic, qui n’est pas publique. Google précise par ailleurs qu’il sanctionne la production massive de pages sans valeur, pas le mode de fabrication d’un texte.
Un outil de nettoyage peut-il vraiment retirer un filigrane ?
La recherche a montré qu’un filigrane statistique peut être effacé par réécriture, avec plus de 90 % de réussite sur le procédé dont Anthropic s’inspire. Ces essais portaient toutefois sur des modèles ouverts, clé en main. Aucun outil grand public ne peut aujourd’hui démontrer le même résultat sur Claude, puisqu’aucun détecteur public n’existe pour le vérifier.
Un texte court peut-il porter un filigrane ?
Difficilement. Sur un petit échantillon, la détection devient très difficile. Le procédé a besoin d’un grand nombre de choix de mots pour former un motif repérable, et Anthropic reconnaît que la détection fonctionne mal sur de petits échantillons. Une publication de deux cents mots peut donc rester hors de portée, même entièrement rédigée par une machine.
D’autres questions sur la création et la vie d’un site trouvent leur réponse sur la page des questions fréquentes.
Sources
Les citations en anglais ont été traduites par Graph’Web Studio. Le texte d’origine est accessible via les liens.
Textes officiels et institutions
- CISA, compromission de l’écosystème npm, 23 septembre 2025
Documentation officielle d’un éditeur
- Anthropic, How Claude’s text watermarking works, 14 août 2026
- Anthropic, How Claude marks AI-generated content, centre d’aide
- Google, SynthID Text
- OpenAI, retrait du classifieur de détection, 20 juillet 2023
- Google Search Central, contenu produit par IA générative
- guillaumemeyer, watermarks-remover
Recherche évaluée par les pairs
- Kirchenbauer et al., A Watermark for Large Language Models, ICML 2023
- Kirchenbauer et al., On the Reliability of Watermarks, ICLR 2024
- Dathathri et al., Scalable watermarking for identifying LLM outputs, Nature 634, octobre 2024
- Zhang et al., Watermarks in the Sand, ICML 2024
- Sadasivan et al., Can AI-Generated Text be Reliably Detected ?, TMLR
- Liang et al., Watermark under Fire, Findings of EMNLP 2025
Préprints et billets de laboratoire
- Jovanović, Gloaguen et Vechev, SRI Lab, ETH Zurich, Probing Google DeepMind’s SynthID-Text Watermark, 20 décembre 2024
Test technique de première main
- Pasquale Pillitteri, ingénieur logiciel, Claude Watermark Remover on GitHub, What Works and What Doesn’t, août 2026
Presse et rapports de secteur
- BleepingComputer, AI watermark removers flood the web, 13 août 2026
- Wall Street Journal, There’s a Tool to Catch Students Cheating With ChatGPT. OpenAI Hasn’t Released It., 4 août 2024, article payant
Communication commerciale
- Originality.AI, Invisible Text Detector and Remover