Résumé de l’articleVous manquez de temps aujourd’hui ? Voici l’essentiel en quelques lignes. Vous pourrez revenir à l’article complet plus tard. Lire le résuméMasquer le résumé
Un site peut être impeccable, rapide, bien référencé sur Google, et rester introuvable quand un inconnu pose sa question à ChatGPT. Pas mal classé… absent. Je l’ai découvert sur mon propre site d’art, en cherchant tout autre chose, et ce que j’ai trouvé dessous m’a d’abord intriguée, puis franchement alarmée.
L’essentiel
Tout se joue sur une confusion, celle des trois robots d’OpenAI, qu’on met volontiers dans le même sac alors qu’ils ne font pas du tout le même travail.
- ChatGPT-User lit une page quand une action dans ChatGPT le déclenche. C’est lui qui vous cite, le jour où c’est vous qui servez votre adresse sur un plateau.
- OAI-SearchBot construit l’index de ChatGPT Search, celui qui fait surgir votre nom devant quelqu’un qui ne vous connaît pas. C’est lui qui compte.
- GPTBot aspire du contenu pour entraîner les modèles. Le bloquer ne dit rien du sort des deux autres.
D’où la vérification qui rassure pour rien. Demander à ChatGPT s’il connaît votre site réveille le premier robot, pendant que le deuxième dort peut-être depuis des mois… et votre test ne le verra jamais.
Sur mon site d’art, OAI-SearchBot et Applebot, celui qui alimente Siri, Spotlight et Safari, totalisaient zéro visite depuis l’ouverture, quand Googlebot y figurait plus de 1 500 fois. Mon robots.txt les autorisait pourtant noir sur blanc. Sans le moindre effet, parce que la coupure se produisait au niveau du serveur, avant que la requête n’atteigne le site. Pas de code 403, pas de page d’erreur, pas une ligne dans les journaux. Une absence, et rien d’autre.
L’hébergeur a fini par confirmer un blocage volontaire, appliqué à tout son parc mutualisé, sans exception possible et en place depuis longtemps. Sa page d’aide, elle, affirme toujours qu’aucun robot d’IA n’est bloqué par défaut. Le motif se défend, un robot gourmand met en péril un serveur partagé. L’instrument beaucoup moins, puisqu’il laissait passer GPTBot, celui qu’on bloque d’habitude, et coupait celui qui porte votre visibilité.
Bonne nouvelle quand même, refuser l’entraînement n’oblige pas à se saborder. OpenAI et Anthropic séparent leurs robots selon l’usage, on peut donc fermer une porte et laisser l’autre grande ouverte. Reste qu’un robots.txt n’arrête que les robots honnêtes, et pour une œuvre, mieux vaut le savoir.
Quant à l’enjeu, il a changé d’échelle. OpenAI annonçait fin février 2026 plus de 900 millions d’utilisateurs actifs par semaine, un chiffre qui compte des utilisateurs et non des recherches. Manquer à l’index, c’est manquer la sélection avant même que la comparaison commence… et ne jamais l’apprendre.
Ce que la lecture complète de l’article apporte en plus
La commande de trente secondes qui tranche la question chez vous, et surtout la façon de ne pas mal lire son résultat (le même code peut vouloir dire deux choses opposées). Les deux réponses de l’hébergeur, mot pour mot. Le tableau des robots d’indexation, moteur par moteur, avec ce que vous perdez en coupant chacun. Et les quatre gestes à poser une fois qu’on sait.
Le tout s’appuie sur des sources solides, dont la liste complète se trouve en fin d’article, tout autant que la mini FAQ. Rien de ce qui est avancé ici ne repose sur une impression.
Votre site est impeccable. Rapide, soigné, bien référencé sur Google. Et pourtant, quand quelqu’un pose une question à ChatGPT dans votre domaine, il n’apparaît nulle part. Pas mal classé. Pas cité en dernier. Absent.
Je construis des sites sur-mesure, et je fais le nécessaire pour qu’on les trouve, sur Google comme dans les réponses des IA. C’est le métier de web designer, que j’exerce en même temps que celui d’artiste peintre numérique. Alors le jour où j’ai compris qu’un site pouvait être rayé de la recherche ChatGPT en silence, sans le moindre signal, ça m’a retournée.
Retenez déjà ceci. Être visible dans les IA, ça ne se demande pas à une IA… Ça se mesure. Un site peut être cité sans jamais être trouvé, et personne ne vous préviendra de la différence.
Information
Cet article a été écrit en juillet 2026, ses relevés datent des 9 et 10 juillet. Re-testé le 6 septembre, l’hébergeur laisse désormais passer OAI-SearchBot, le robot qui alimente la recherche de ChatGPT. Applebot et YandexBot restent coupés exactement de la même façon, sans réponse et sans trace. Le mécanisme n’a pas bougé, sa liste de robots, si.
Comment je suis tombée là-dessus
Tout est parti de mes peintures numériques. En tant qu’artiste, je voulais empêcher les IA d’aspirer mes œuvres pour s’entraîner dessus, sans pour autant disparaître des recherches. Sur mon site d’art, graphartstudio.com, ces deux exigences semblaient tirer chacune de son côté. Protéger, tout en restant trouvable.
En cherchant à régler ça proprement, deux ou trois paramètres refusaient obstinément de produire l’effet promis. J’ai gratté. Ce que j’ai trouvé dessous m’a d’abord intriguée, puis franchement alarmée. Le problème ne venait ni de moi, ni de mes réglages. Il venait d’un cran plus bas, là où on ne pense jamais à regarder.
Cette histoire ne concerne pas que mes peintures. Elle peut toucher n’importe quel site, y compris le vôtre, sans que vous en sachiez jamais rien.
Cité n’est pas indexé
Tout se joue sur une confusion. Quand on dit « ChatGPT lit mon site », on parle en réalité de deux robots bien distincts que l’on confond volontiers en un seul. Et cette confusion peut coûter cher.
Le premier, ChatGPT-User, entre en jeu lorsqu’une action dans ChatGPT déclenche la consultation d’une page web. Vous pouvez par exemple lui donner une adresse et lui demander d’aller voir. Il lit alors la page en direct, sur commande. C’est lui qui vous cite lorsque c’est vous qui lui servez votre adresse sur un plateau.
Le second, OAI-SearchBot, ne vient jamais sur commande. Il ratisse le web en continu pour bâtir l’index de ChatGPT Search, celui qui fait surgir votre nom quand un inconnu pose sa question sans vous connaître. C’est lui, la découverte. C’est lui qui compte.
Ajoutez GPTBot, le troisième, qui aspire du contenu pour entraîner les modèles. Celui-là est souvent bloqué, et à raison. Une chose à garder en tête, pourtant. Bloquer GPTBot ne dit rien du sort d’OAI-SearchBot. Trois robots, trois serrures, trois décisions séparées. Les confondre, c’est croire qu’on a fermé sa maison parce qu’on a verrouillé le garage.
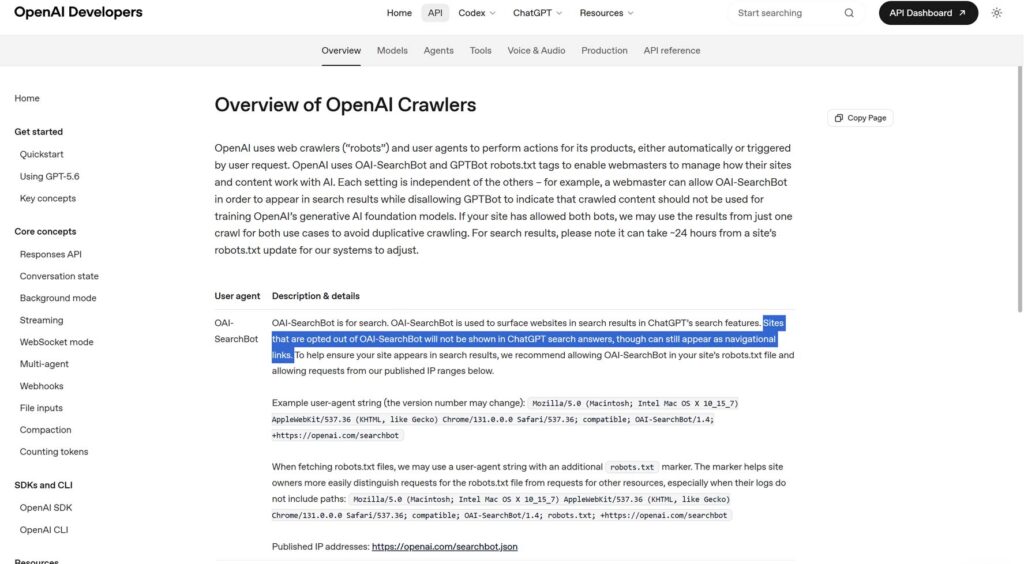
OpenAI est précis sur ce point. Un site qui refuse OAI-SearchBot n’est pas affiché dans les réponses de recherche de ChatGPT. Il peut toutefois encore apparaître sous forme de lien de navigation. Dans les réponses de recherche, vous n’êtes pas mal classé, vous en êtes absent.
| Le robot | Ce qu’il fait | Ce que vous perdez en le bloquant |
|---|---|---|
| ChatGPT-User | lit une page en direct lorsqu’une action dans ChatGPT déclenche sa consultation | la lecture à la demande de vos pages |
| OAI-SearchBot | bâtit l’index de ChatGPT Search, celui qui vous fait surgir devant un inconnu | votre présence dans les réponses de recherche ChatGPT, hors possibles liens de navigation |
| GPTBot | aspire du contenu pour entraîner les modèles | rien de votre visibilité dans ChatGPT Search, seulement l’usage de vos textes à l’entraînement |
Le test qui rassure à tort
Le vrai piège dans l’histoire, c’est la fausse assurance. Pour vérifier leur présence dans ChatGPT, la plupart des gens le demandent à… ChatGPT. Le réflexe est humain, quoi de plus normal. On ouvre l’application, « tu connais mon site ? », il répond oui, il cite une page. Et là, grand soulagement. Sauf que ce test ne prouve rien.
En donnant votre adresse, vous réveillez ChatGPT-User, le lecteur à la demande. Vous frappez à la bonne porte, mais avec la mauvaise question. Cette réussite ne dit rien, à elle seule, de l’accès du robot utilisé pour la recherche. Pendant ce temps, OAI-SearchBot dort, peut-être coupé depuis des mois, et votre test ne le verra pas.
Et il y a même plus retors. Quand une IA vous « répond » sur votre activité, ça ne prouve pas qu’elle a lu votre site. Elle brode souvent à partir de ce qu’elle sait déjà. Répondre n’est pas lire, et pour en avoir le cœur net, il faut mesurer, pas bavarder avec la machine.
Le piège est presque élégant. Cité quand vous vous invitez, introuvable quand on vous cherche. L’exact inverse de ce qu’un site est censé faire.
Attention
Demander à ChatGPT de consulter votre site ne prouve pas sa présence dans Search. ChatGPT-User et OAI-SearchBot répondent à deux usages différents, et la lecture réussie d’une page ne dit rien de ce que le robot de recherche peut atteindre. Un site absent des réponses de recherche depuis des mois peut très bien répondre « oui, je te connais ».
Et ce n’est pas que ChatGPT
Je me suis concentrée sur ChatGPT, parce que c’est le nom que tout le monde a en tête. Pourtant, réduire la visibilité IA à ChatGPT serait une erreur. Une erreur qui coûte cher.
Plusieurs moteurs de réponse ont leur propre robot d’indexation. ChatGPT Search a OAI-SearchBot. Perplexity a PerplexityBot. Claude a Claude-SearchBot. Et puis il y a le grand oublié, celui auquel presque personne ne pense. Apple.
Le robot d’Apple s’appelle Applebot. Il alimente Siri, Spotlight, Safari, et désormais Apple Intelligence. Chez Apple, un seul robot fait les deux métiers, et les données qu’il collecte peuvent aussi servir à entraîner leurs modèles. Pour refuser cet entraînement sans quitter la recherche, il faut interdire Applebot-Extended, un second nom qui n’explore rien de son côté. Autrement dit, une partie de ce qu’un utilisateur d’iPhone déclenche sans même ouvrir un navigateur. Quand quelqu’un demande à Siri de lui trouver un prestataire, ou tape trois mots dans Spotlight, c’est Applebot qui a préparé ce qu’il voit. Le couper, c’est fermer l’une des portes par lesquelles des millions d’appareils Apple peuvent découvrir votre site, sans un bruit.
Sur le site que j’ai testé, quatre robots d’indexation légitimes étaient réellement coupés, ceux de ChatGPT Search, d’Apple, de Yandex et de Petal Search. Quatre moteurs, quatre publics entiers, effacés d’un coup. Coupés avec eux, d’autres robots comme Amazonbot ou Bytespider. Épargnés, en revanche, Perplexity, Claude, Mistral, DuckDuckGo, Google et Bing.
| Le moteur de réponse | Son robot d’indexation | Sur le site testé |
|---|---|---|
| ChatGPT Search | OAI-SearchBot | coupé |
| Apple (Siri, Spotlight, Safari, Apple Intelligence) | Applebot | coupé |
| Yandex | YandexBot | coupé |
| Petal Search (Huawei) | PetalBot | coupé |
| Perplexity | PerplexityBot | épargné |
| Claude | Claude-SearchBot | épargné |
| Mistral, DuckDuckGo, Google, Bing | non détaillés ici | épargnés |
| Autres robots | Amazonbot, Bytespider | coupés |
Regardez bien ce tri. Il fait tomber deux moteurs de recherche parfaitement fréquentables dans le même filet que les autres robots, et laisse filer le reste. On se croit couvert parce que Google passe, et on oublie tous les autres.
Pourquoi ce blocage est-il invisible ?
Un blocage normal, ça se voit. Vous demandez une page, le serveur répond « non » avec un code 403, et cette réponse laisse une trace. Vous pouvez la lire, la comprendre, la corriger. Ici, rien de tout ça.
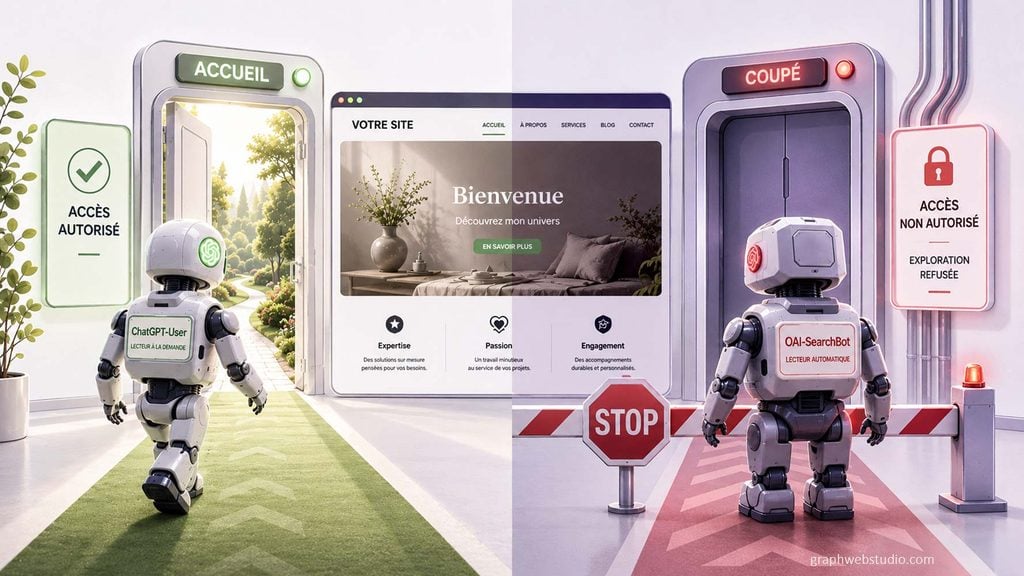
La coupure intervient au niveau du serveur, avant même que la requête n’atteigne votre site. La connexion s’ouvre, le robot annonce son nom, et le serveur referme la porte sans un mot. Bye bye ! Pas de 403, pas de page d’erreur, aucune réponse.
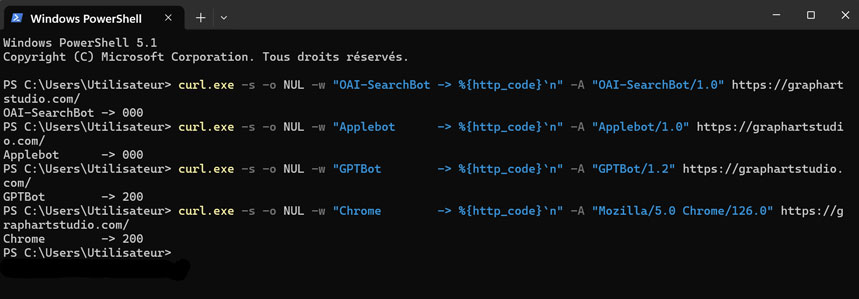
Dans mon test, la commande renvoyait un code 000, autrement dit aucun code HTTP reçu. Surtout, elle ne laissait aucune trace. Pas une ligne dans le journal d’accès, rien dans le journal d’erreurs. Du point de vue de votre site, ce robot n’est jamais venu.
Les journaux le confirment sans appel. Sur mon propre site d’art, celui-là même où toute l’enquête a commencé, OAI-SearchBot et Applebot totalisent zéro visite depuis l’ouverture. Zéro. Pendant que Googlebot y figure plus de 1 500 fois et Bing plus de 1 100, au relevé de mes journaux d’accès. Ces chiffres, je ne les invente pas, je les ai lus dans mes propres fichiers serveur. Deux robots majeurs absents à cent pour cent, et je ne m’en étais jamais doutée. Voilà pourquoi ça reste invisible.
On ne remarque pas une absence, surtout dans un fichier que l’on n’ouvre jamais !
Ce qui rend l’affaire encore plus vicieuse tient à un autre détail. Votre robots.txt a beau autoriser le robot en question noir sur blanc (ce qui est le cas chez moi), ça ne change rien, car la coupure a lieu bien avant qu’on ne lise ce fichier. Le robots.txt n’est qu’une demande polie posée à l’entrée de votre site. La coupure serveur, elle, se produit sur le trottoir, avant la porte. Autoriser un robot qu’on refoule cent mètres plus loin, c’est lui tendre un badge d’accès après l’avoir déjà mis dehors.
Quand la documentation dit l’inverse
En cherchant à comprendre, j’ai trouvé plus dérangeant encore. La documentation publique de cet hébergeur affirme qu’« il n’y a aucune restriction particulière empêchant les robots des services d’intelligence artificielle d’accéder à votre domaine ». Or mes tests disent le contraire. La même adresse répond, ou se fait couper, selon le seul nom du robot annoncé. Changez le nom, le résultat change. C’est bien le nom du robot qui déclenche la coupure, et rien d’autre.
Le comble, pour finir. En juillet, le propre site d’aide de cet hébergeur subissait exactement le même blocage, sur ce même robot, pendant que sa page dédiée jurait qu’aucun robot d’IA n’est filtré. Sa documentation se contredisait toute seule.
Un propriétaire de site logé là ne dispose donc d’aucun signal. Le symptôme, c’est une absence dans des journaux que personne ne consulte un dimanche soir… et l’invisibilité dans les réponses de ChatGPT entre autres.
Il faut aller chercher le problème pour le voir, et personne ne cherche un problème dont il ignore l’existence. Enfin, presque personne… Il y a toujours une insomniaque, quelque part, pour éplucher un journal serveur à trois heures du matin.
Comment tester en trente secondes ?
Assez de théorie. Voici comment vérifier vous-même, en quelques secondes, si votre site est concerné. Pas besoin d’être développeur pour lire le résultat. Ouvrez un terminal et collez une ligne.
curl -o /dev/null -w "%{http_code}" -A "OAI-SearchBot/1.0" https://votresite.fr/Cette commande réclame votre page d’accueil en se présentant sous le nom du robot d’indexation de ChatGPT. Elle affiche un simple code. Un 200, la requête reçoit bien une réponse du serveur. Un 000, aucune réponse HTTP n’est revenue, et quelque chose coupe la communication en chemin. Si vous avez Cloudflare devant votre site, un code en 52x peut apparaître à la place. Là encore, la requête n’est pas arrivée au bout, même si la cause précise demande un second regard.
Refaites ensuite exactement le même test avec Applebot, en changeant juste le nom.
curl -o /dev/null -w "%{http_code}" -A "Applebot/1.0" https://votresite.fr/Comment ne pas mal lire le résultat ?
Un point de méthode, car sans lui vous risquez de mal lire le résultat. Après le robot, testez tout de suite un navigateur ordinaire, sur la même connexion, en changeant seulement le nom.
curl -o /dev/null -w "%{http_code}" -A "Mozilla/5.0 Chrome/126.0" https://votresite.fr/C’est la comparaison des deux qui tranche. Si le robot renvoie 000 et le navigateur 200, le nom annoncé par la requête change bien son traitement. Vous tenez un indice très sérieux. En revanche, si les deux renvoient 000, le robot n’y est pour rien, c’est votre propre adresse IP qu’on bloque à cet instant, un pare-feu un peu nerveux, ça arrive. Deux diagnostics opposés, une seule ligne d’écart. Ne sautez pas cette vérification.
Pas à l’aise avec le terminal ?
Il existe deux façons de faire ce test sans jamais ouvrir de terminal. Cette ligne de commande vous parle peu ? Vous avez deux portes de sortie. D’abord, demandez à la personne qui gère votre site de lancer le test, ça lui prend une minute. Sinon, passez par un testeur de user-agent en ligne, qui permet de lancer ce type de requête sans ligne de commande. L’important est de déposer la question devant la bonne porte. L’outil vient après.
Pour aller plus loin, vos journaux serveur tranchent définitivement. Cherchez-y OAI-SearchBot et Applebot sur tout l’historique. S’ils n’apparaissent jamais alors que Googlebot y grouille, vous tenez votre réponse. C’est d’ailleurs par là que toute cette histoire a commencé, par une absence dans un fichier que personne ne lit.
Pourquoi un hébergeur en arrive-t-il là ?
À ce stade, on pourrait crier à la malveillance. Ce n’en est pas, et la vraie explication est plus intéressante.
Sur un hébergement mutualisé, plusieurs dizaines de sites partagent le même serveur physique. Les ressources sont communes. Un robot qui réclame des milliers de pages en rafale pompe donc la puissance des voisins et peut faire vaciller l’ensemble. Or certains robots d’indexation, dont celui d’OpenAI, explorent de façon très gourmande. Protéger le serveur contre ce pilonnage reste une décision d’exploitation parfaitement défendable. D’autres hébergeurs le font… mais l’assument sans se cacher.
Le principe se défend, donc. L’instrument, beaucoup moins. Ce genre de blocage s’appuie souvent sur une liste de noms de robots écrite pour repousser les aspirateurs de contenu, une liste qui n’a jamais trié l’aspirateur agressif du moteur de recherche légitime. Résultat, elle attrape dans ses filets des robots parfaitement fréquentables, comme celui d’Apple ou celui de ChatGPT Search.
Le tri fin existe pourtant, et je l’ai constaté sur d’autres sites. Les vrais aspirateurs, Bytespider ou Amazonbot, y étaient coupés quand OAI-SearchBot et Applebot passaient tranquillement. Preuve qu’on peut protéger un serveur sans sacrifier la visibilité de ses clients. La différence ne tient pas à la technique. Elle tient à la volonté de faire ce tri, ou de ne pas le faire.
Et ici, le tri n’a pas été fait. Pas par accident. La preuve que la liste ne réfléchit pas ? GPTBot, le robot d’entraînement d’OpenAI, celui qu’on bloque justement d’habitude, passait tranquillement. Alors qu’OAI-SearchBot, celui qui fait votre visibilité, se faisait couper. Comprenne qui pourra…
Ce que l’hébergeur m’a répondu
J’ai posé la question dans un message détaillé, une page et demie, où j’exposais chaque test un par un et posais plusieurs questions précises. En retour, quatre lignes, qui répondaient à une seule d’entre elles. Les voici, mot pour mot.
« Malheureusement ce sont deux bots qui sont bloqués par le serveur. Nous ne bloquons pas tous les bots, mais ces deux là et en particulier celui d’OpenAI génère un nombre incommensurable de requêtes, ce qui peut ensuite nuire à la stabilité de nos services ensuite. En revanche, même sans ce bot, votre site peut être affiché par GPT, simplement, il n’est pas indexé directement. »
La première moitié est honnête, et elle confirme tout. Le blocage est voulu, posé au niveau du serveur, pour une question de volume. La seconde mérite une nuance. Oui, un site privé d’OAI-SearchBot peut encore apparaître dans ChatGPT, notamment sous forme de lien de navigation. Mais OpenAI est tout aussi clair sur l’autre moitié du tableau. Sans OAI-SearchBot, le site n’apparaît pas dans les réponses de recherche.
J’ai donc relancé sur les points laissés de côté. Une exception était-elle possible ? La règle touchait-elle tout leur parc ? Depuis quand existait-elle ? Cette fois, la réponse a tenu en trois phrases.
« Aucune exception ne sera faite dans un contexte d’hébergement mutualisé, malheureusement. Cette sécurité s’applique à l’ensemble de notre parc, pas uniquement votre compte ou votre serveur. Et cette règle est en place depuis longtemps, ce n’est pas une règle récente. »
Tout est là. Aucune marge de manœuvre, le comportement vise toute la plateforme, et la règle est ancienne. Elle n’a donc rien d’un bug récent. Elle est en place depuis longtemps, en connaissance de cause, et maintenue telle quelle pendant que la documentation affirme le contraire. Bloquer un aspirateur qui pilonne un serveur, je l’entends. Le faire en silence et en écrivant l’inverse noir sur blanc, beaucoup moins.
Peut-on refuser l’entraînement sans se saborder ?
Oui, et OpenAI comme Anthropic, pour ne citer qu’eux, l’ont prévu en séparant leurs robots selon leur usage. Revenons à mon problème de départ, celui de l’artiste. Comment refuser que les IA s’entraînent sur mes œuvres, sans disparaître des recherches pour autant ? Les deux exigences semblent s’opposer. Elles ne s’opposent pas, à condition de viser juste.
OpenAI et Anthropic, pour ne citer qu’eux, ont séparé leurs robots selon leur usage. D’un côté, ceux qui peuvent collecter du contenu pour l’entraînement, comme GPTBot ou ClaudeBot. De l’autre, ceux qui explorent le web pour la recherche, comme OAI-SearchBot ou Claude-SearchBot. PerplexityBot, lui aussi, sert à faire apparaître les sites dans les résultats de Perplexity. Vous pouvez fermer la première porte et laisser la seconde grande ouverte. C’est ce qui se règle dans le robots.txt, où l’on refuse poliment les robots d’entraînement tout en autorisant ceux d’indexation.
Reste une vérité qu’on tait un peu trop souvent. Un robots.txt n’arrête que les robots honnêtes. C’est un panneau, pas un mur. Une pancarte « prière de ne pas entrer » posée sur une porte grande ouverte. Les visiteurs corrects s’arrêtent, les autres passent quand même. Pour une œuvre, mieux vaut le savoir avant de se croire à l’abri.
La vraie protection est alors ailleurs. Elle est d’abord juridique, avec un signal de réservation de droits lisible par les machines, adossé à la directive européenne sur le droit d’auteur. À noter, ce signal constitue un dossier daté, sans dresser de mur pour autant. Et pour des images, la meilleure défense reste la résolution des fichiers que vous servez, bien plus qu’un fichier texte.
Le principe à retenir éclaire tout le reste. Refuser l’entraînement ne ferme pas, à lui seul, la porte à la recherche. Ce qui coûte cher, c’est de bloquer par-dessus les robots de citation, par méconnaissance ou avec un outil trop grossier. C’est exactement ce qui se joue chez l’hébergeur de cette histoire, sauf que là, ce n’est pas de la méconnaissance.
Ce que ça coûte, en 2026
L’enjeu a changé d’échelle, et il se compte désormais en centaines de millions de personnes. On pourrait juger tout ça anecdotique. Ça ne l’est plus.
Regardez les ordres de grandeur. Fin février 2026, OpenAI annonçait plus de 900 millions d’utilisateurs actifs chaque semaine sur ChatGPT. Une part énorme du public ne tape plus sa question dans un moteur classique, elle la pose à un assistant et attend une réponse, avec deux ou trois sources citées. Apparaître dans cette poignée de sources devient dès lors un enjeu aussi sérieux que la première page de Google.
Imaginez la scène. Quelqu’un veut refaire le site de son restaurant et n’y connaît rien. Il ouvre ChatGPT et demande « trouve-moi des prestataires qualifiés pour créer le site de mon restaurant à Dijon ». L’assistant cite alors quelques noms. Et si votre nom en fait partie, ce n’est pas par magie, c’est parce que votre hébergeur a laissé passer le robot qui vous a indexé. À l’inverse, si vous manquez à l’index, vous n’êtes pas dans la course.
Vous n’avez pas perdu face à un concurrent plus expérimenté ou qui travaille mieux que vous. Non. Vous avez perdu parce que vous n’étiez pas sur la ligne de départ. Et le pire, c’est que vous ne le saurez jamais, car rien ne vous le dira.
C’est ce point-là qui m’a le plus remuée. On passe un temps considérable à rendre les sites lisibles et citables par les IA. Alors découvrir qu’un simple réglage d’hébergement, posé en amont et en silence, peut réduire ce travail à néant sans avertir personne, ça n’est pas une petite contrariété. On ne travaille pas la visibilité d’un site pour la laisser saboter par une couche qu’on ne maîtrise pas. Ça doit rester un choix…
Information
Le chiffre de 900 millions vient d’une annonce d’OpenAI de fin février 2026, et il compte des utilisateurs actifs par semaine, pas des recherches. Tous ne posent pas une question qui appelle des sources. L’ordre de grandeur, lui, ne se discute pas, et c’est ce qui compte ici.
Que faire, concrètement ?
Quatre gestes, du plus simple au plus engageant.
- D’abord, testez. La commande plus haut prend trente secondes. Lancez-la sur OAI-SearchBot et sur Applebot, au minimum. Tout part de là, savoir de quel côté vous vous trouvez.
- Ensuite, écrivez à votre hébergeur. Si le test révèle une différence, ouvrez un ticket et posez la question sans détour. Ces robots d’indexation sont-ils coupés au niveau du serveur, et une exception reste-t-elle possible ? Et testez aussi son propre site, vous pourriez avoir des surprises.
- Puis réglez votre robots.txt. C’est nécessaire, mais rappelez-vous, ce n’est pas suffisant. Séparez bien les robots d’entraînement, que vous pouvez bloquer pour protéger votre contenu, de ceux destinés à la recherche, qu’il faut laisser passer puisqu’ils portent votre visibilité. Un robots.txt bien réglé ne vaut rien si une couche au-dessus coupe déjà la ligne. Mal réglé, en revanche, il suffit à vous rendre invisible tout seul.
- Enfin, si le blocage vient de l’hébergeur, tirez-en les conséquences. C’est le choix devant lequel je me suis retrouvée. Quand une infrastructure coupe en amont, sans exception possible et sur tout son parc, il n’y a rien à négocier. J’ai donc décidé de déplacer mes sites ailleurs. Je ne peux pas, en conscience, promettre à mes clients un vrai travail de visibilité pour le laisser réduire à néant par une couche que je ne contrôle pas.
Un hébergeur ne se contente plus de garder un site en ligne
Je vais être franche, car cette conviction traverse tout l’article. Un hébergeur qui protège ses serveurs, je le comprends et je le respecte. Mais héberger, aujourd’hui, ce n’est plus seulement garder un site allumé. C’est le laisser joignable par ceux qui le font exister aux yeux du public. Couper cet accès en douce, en jurant le contraire dans sa documentation, c’est manquer de respect à ses clients, à leur activité, et au travail de ceux qui bâtissent ces sites pour qu’on les trouve.
Revenons au paradoxe du début, ce site parfait que ChatGPT ne trouve pas. Il n’a rien de cassé. Il tourne, il est soigné, il plaît à Google. Et pourtant, pour toute une partie des gens qui pourraient le chercher… IL N’EXISTE PAS.
Voilà l’angle mort.
Pas une panne visible, pas un bug qu’on répare. Une absence silencieuse, pile dans les endroits où se prennent de plus en plus de décisions.
La bonne nouvelle tient en une ligne de commande. En trente secondes, vous savez. Et dans cette histoire, savoir, c’est déjà la moitié du chemin. Le reste n’est qu’une affaire de choix. Mais au moins, faites-le les yeux ouverts.
Questions fréquentes
Qu’est-ce qu’OAI-SearchBot, et en quoi diffère-t-il de GPTBot ?
OAI-SearchBot construit l’index de ChatGPT Search, celui qui fait apparaître votre site dans les réponses. GPTBot, lui, sert à entraîner les modèles d’OpenAI et n’a aucun effet sur votre visibilité dans ChatGPT Search. On bloque souvent le second sans conséquence. Couper le premier, en revanche, vous écarte des réponses de recherche ChatGPT, même si un simple lien peut encore apparaître dans certains cas.
Bloquer GPTBot me fait-il disparaître de ChatGPT ?
Non. GPTBot ne touche qu’à l’entraînement des modèles. Le bloquer refuse cet usage à OpenAI sans réduire votre présence dans les réponses de recherche ChatGPT, qui dépend d’un autre robot, OAI-SearchBot. Ce sont deux réglages entièrement indépendants.
Puis-je bloquer les IA pour protéger mon contenu sans devenir invisible ?
Oui. Les robots d’entraînement, comme GPTBot ou ClaudeBot, se bloquent séparément des robots de citation, comme OAI-SearchBot ou Claude-SearchBot. Refuser l’entraînement dans votre robots.txt ne vous écarte pas, à lui seul, des réponses de recherche. Ce qui vous rend invisible, c’est de bloquer par erreur les robots de citation.
Comment savoir si mon site est concerné ?
Ouvrez un terminal et lancez la commande curl en vous présentant d’abord sous le nom OAI-SearchBot, puis sous celui d’un navigateur, sur la même connexion. Un code 000 pour le robot et 200 pour le navigateur indique un traitement différent selon le nom annoncé. Si les deux renvoient 000, le problème vient d’ailleurs. Pas à l’aise avec le terminal, demandez à la personne qui gère votre site.
Est-ce que seul ChatGPT est touché par ce genre de blocage ?
Non, et c’est le vrai angle mort. Le même mécanisme peut couper Applebot, le robot d’Apple qui alimente notamment la recherche intégrée à Siri, Spotlight et Safari. Presque personne ne pense à le tester, alors qu’il ouvre un nombre incroyable de portes de l’écosystème Apple. Plusieurs moteurs de réponse ont leur propre robot, et n’importe lequel peut être intercepté en amont.
Sources
Textes officiels et institutions
- Union européenne, directive (UE) 2019/790, article 4 (fouille de textes et de données).
- Légifrance, article L. 122-5-3 du code de la propriété intellectuelle (transposition française).
- IETF, Robots Exclusion Protocol, RFC 9309 (le standard du fichier robots.txt).
Documentation officielle d’un éditeur
- OpenAI, documentation officielle des robots (GPTBot, OAI-SearchBot, ChatGPT-User).
- Apple, About Applebot (Siri, Spotlight, Safari, Apple Intelligence).
- Anthropic, documentation officielle des robots (ClaudeBot, Claude-User et Claude-SearchBot).
- Perplexity, documentation officielle de PerplexityBot et des robots Perplexity.
- curl, documentation officielle de la ligne de commande (et de la variable http_code).
- Cloudflare, documentation officielle des erreurs HTTP 5xx.
Presse et rapports de secteur
- OpenAI, How People Use ChatGPT (15 septembre 2025, PDF).
Communication commerciale
- OpenAI, Scaling AI for everyone (27 février 2026).
Ce sujet peut intéresser votre réseau ? Faites-le circuler.